Retour d'expérience : Optimiser Dijkstra en VBA (Gestion de grilles 3D et performances)
Bonjour à tous,
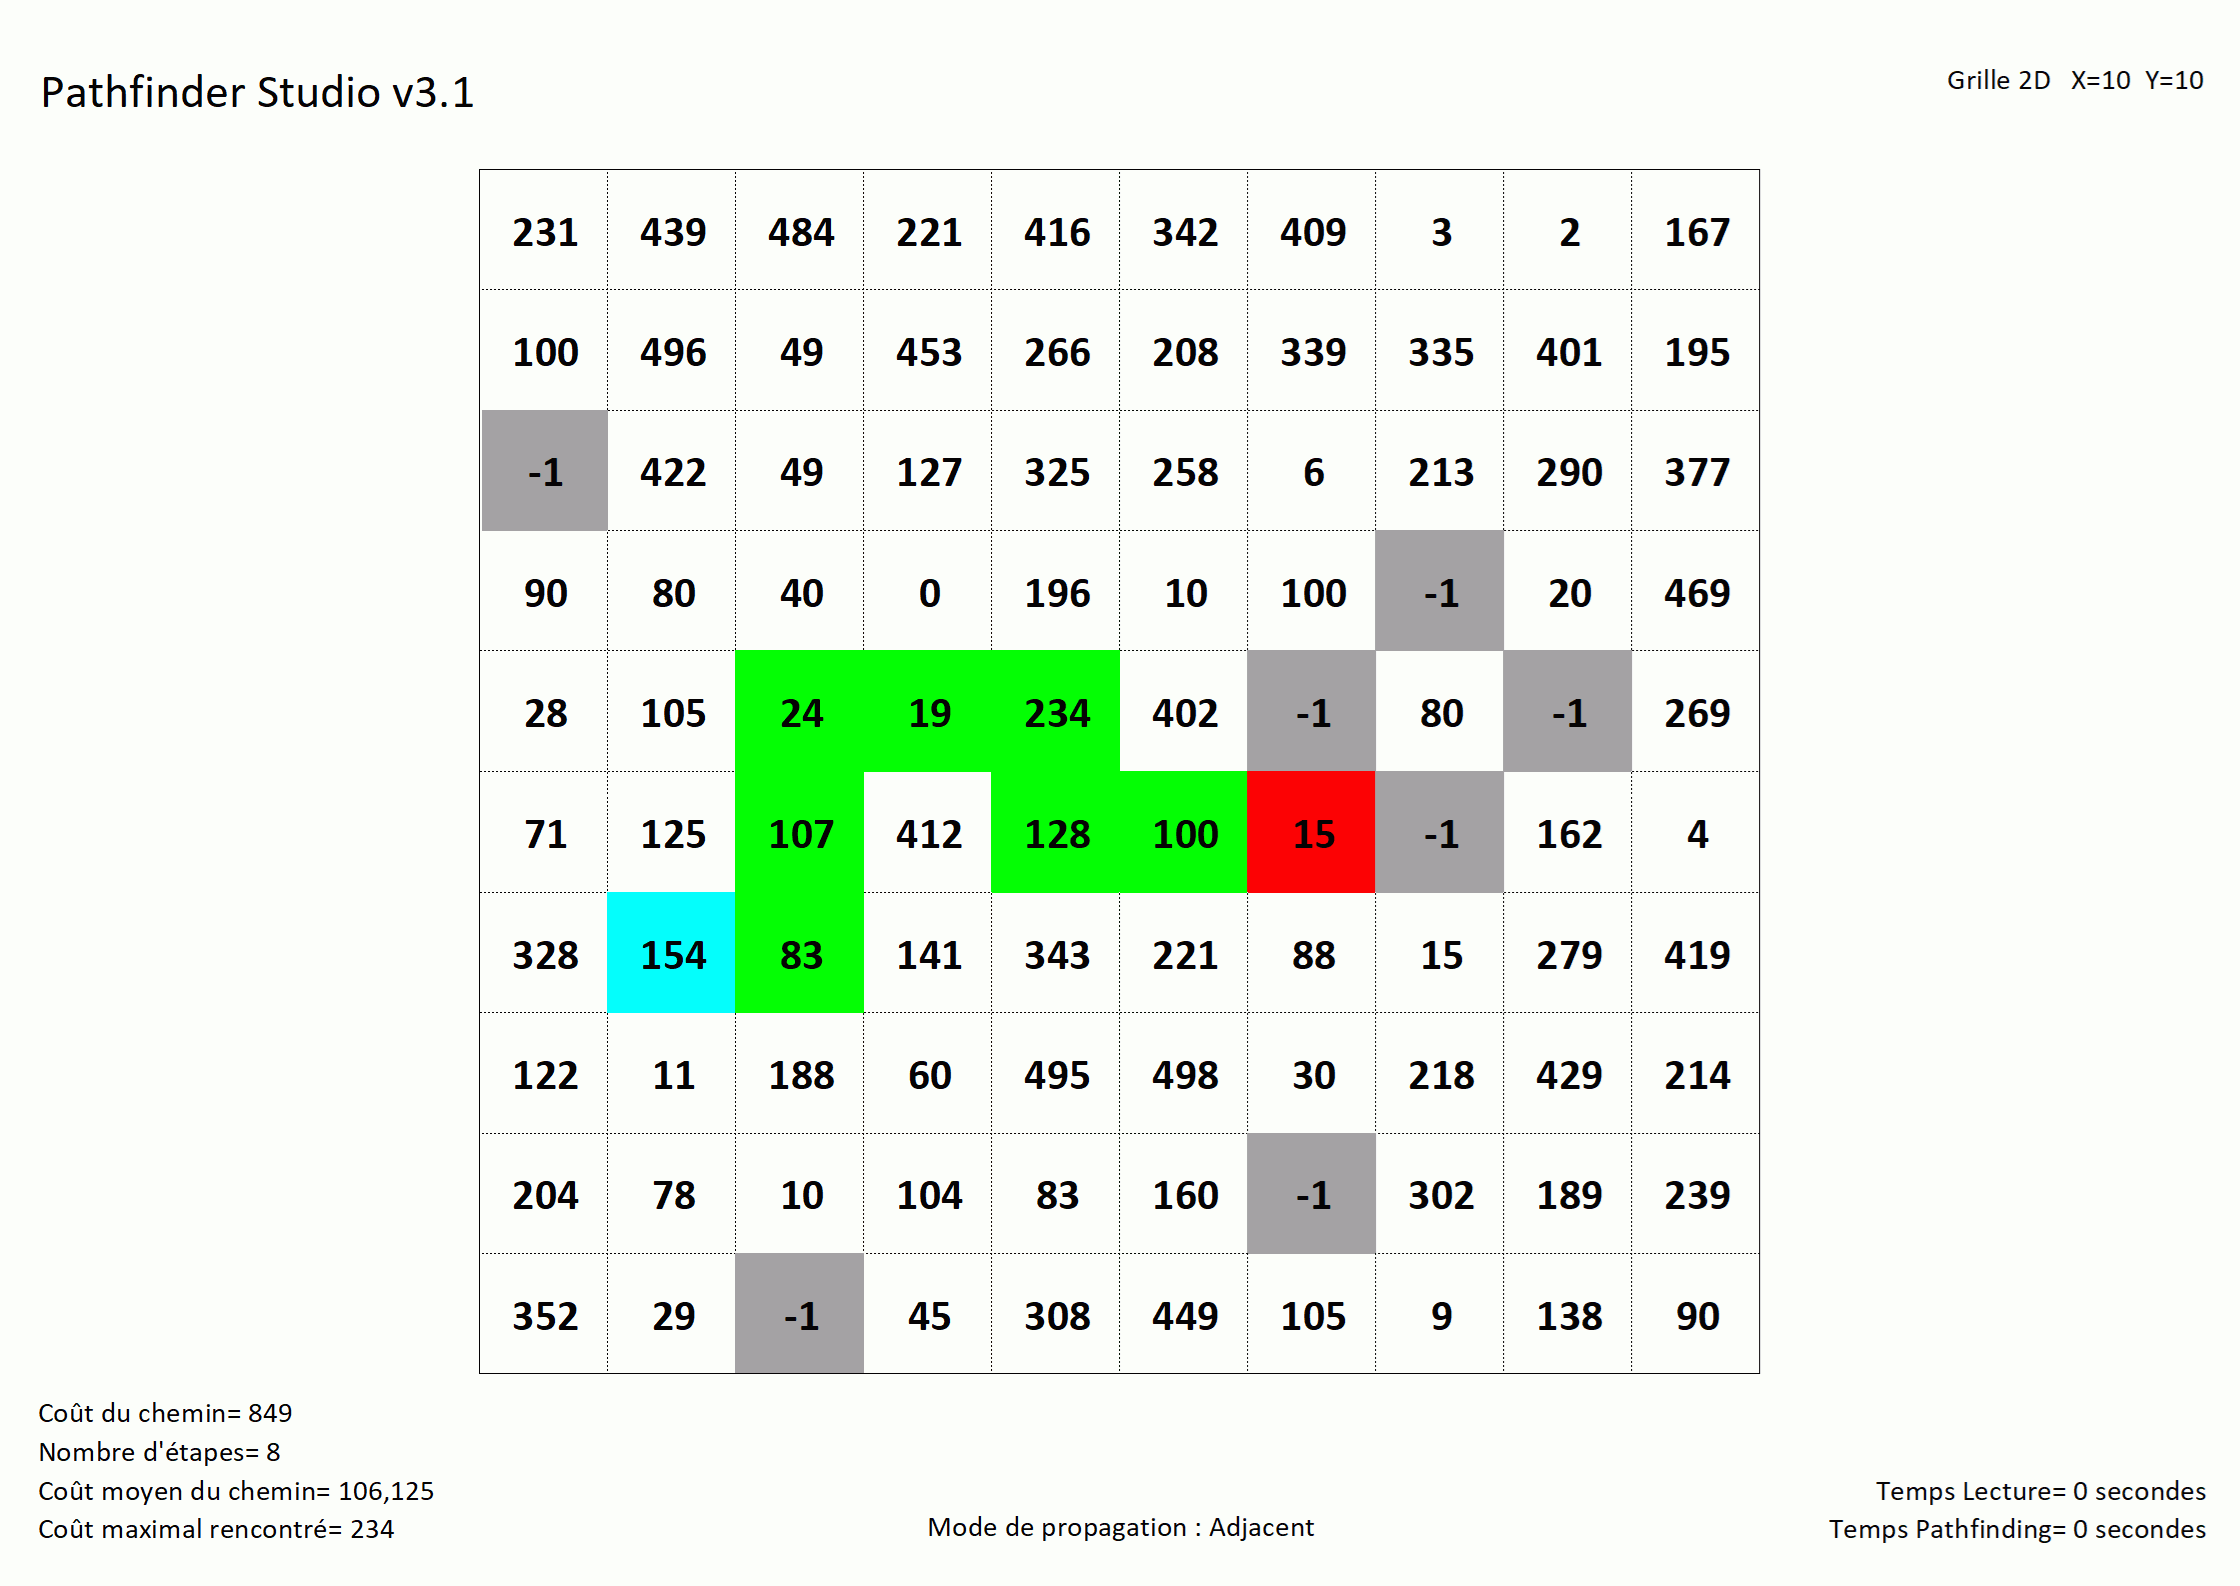
Après pas mal de travail et d'optimisations, je considère mon projet de Pathfinder comme achevé. En poussant l'outil jusqu'à gérer des grilles 3D de 1 000 au cube (soit 1 milliard de cellules !) sous Excel, je me suis heurté aux limites de performance du VBA.
Pour relever le défi, j'ai implémenté deux variantes distinctes de l'algorithme de Dijkstra. J'avais envie de partager ici les choix techniques et les astuces qui m'ont permis de faire tourner tout cela en arrière-plan sans exploser les temps de calcul.
2. L’algorithme 211 (Traitement par lots avec mCCm, NA et LPA)
Ma seconde approche est un Dijkstra plus conventionnel, adapté au type de données Double et optimisé par des astuces de bas niveau, idéal lorsque le nombre de valeurs de coûts distinctes est limité :
- Le traitement groupé : Plutôt que d'étudier point après point, j'intègre dans une variable mCCm (Même Coût Cumulé Minimal) tous les points partageant le même coût minimal en fin de boucle.
- Les sous-boucles de voisinage :
- Je calcule le coût des voisins immédiats et les trie par ordre décroissant dans un tableau de taille limitée NA (Nouvellement Atteintes) via un tri de Shell.
- Si aucun nouveau voisin n'est trouvé, je zappe complètement les étapes suivantes pour gagner du temps.
- Sinon, j'injecte et fusionne ces points dans un tableau principal LPA (Liste des Points Atteints) maintenu en ordre décroissant.
- La fuite rapide (Exit For) : Je parcours LPA en partant de la fin et je m'arrête dès que les nouveaux voisins ne rivalisent plus avec les premiers éléments, m'évitant de balayer toute l'étendue du tableau.
- Les inconvénients de cet algorithme : Les temps de calcul sont rédhibitoires sur les très grosses grilles ( > 1000 x 1000) et incapable de solutionner efficacement les grilles en 3D
1. L’algorithme 222 (Basé sur un tableau de coûts cumulés)
Pour la seconde approche, j'ai structuré mes données sous la forme d'un tableau de seaux de coûts (que j'ai découvert plus tard correspondre à l'algorithme de Dial de 1969).
- Le principe : Les coûts étant contraints à des entiers (Integer 32 767), je stocke les points dans une variable tableau CCs indexée directement par leur coût cumulé.
- L'optimisation : Au lieu de faire un tri lourd à chaque étape, l'algorithme fait simplement « défiler » les indices de ce tableau vers l'avant jusqu'au prochain seau non vide. L'insertion d'un voisin se fait instantanément, ce qui élimine les surcoûts d'une file de priorité classique en VBA.
- Les limites et inconvénients : Cet algorithme se heurte vite à la limite de mémoire allouée pour un tableau de données de 8 octets. Cela limite le coût maximal du chemin le plus coûteux à environ 134 * 10 ^ 6 (= (2147483647 / 8) / 2). / 2 car la taille du tableau peut être 2 fois supérieure au coût du chemin.
Les performances sont fonction du coût du chemin, de hautes valeurs de random augmentent les temps de calcul.
- Les avantages : cet algorithme est très rapide, permet d’affronter des grilles de très grandes dimensions sans perte de performance significative et est efficace en 3D.
Pour le moment la dernière version de mon pathfinder est disponible sur le premier Post de ce fil.
Bon code à vous !