Exctration données PDF par power query sur Excel
Bonjour,
J'ai plein de fichier PDF de ce genre dans un dossier avec la même structure et je voudrais extraire les données suivantes :
Numéro de facture : 2026-07-6562
Date d'émission facture initiale / facture rectificative : 01/07/2026
Montant à payer montant brut 302,40
livraison/réalisation de prestation : ANGERS
pour tous les PDF
J'ai commencé un code mais cela ne fonctionne pas
let
    // 1. Récupération du chemin du dossier depuis votre cellule Excel
    CheminDossier = Excel.CurrentWorkbook(){[Name="Fichier.xml"]}[Content]{0}[Column1],
    Source = Folder.Files(CheminDossier),

    // 2. Filtrage pour ne garder que les fichiers PDF
    FiltrePDF = Table.SelectRows(Source, each [Extension] = ".pdf"),

     // 3. Fonction personnalisée intégrée pour extraire et nettoyer le texte de TOUTES les pages du PDF
    ExtraireTextePDF = Table.AddColumn(FiltrePDF, "TexteBrut", each
        let
            // Extraction des données de toutes les pages du PDF
            PagesPdf = Pdf.Tables([Content], [Implementation="1.3"]),
            // On garde toutes les pages, pas seulement les tables
            FiltrerPages = Table.SelectRows(PagesPdf, each [Kind] = "Page"),
            // Fusion de toutes les pages en un seul gros bloc textuel
            CombinerTexte = Text.Combine(
                List.Transform(
                    FiltrerPages[Data],
                    each Text.Combine(List.Transform(Table.ToList(_), each Text.From(_)), " ")
                ),
                " "
            )
        in
            if Text.Length(CombinerTexte) = 0 then
                "Aucune donnée trouvée"
            else
                CombinerTexte
    ),

    // 4. Extraction chirurgicale des 4 données recherchées via des fonctions de texte
    ExtractionDonnees = Table.AddColumn(ExtraireTextePDF, "InfosFacture", each
        let
            Texte = [TexteBrut],

            // A. Extraction du Numéro de facture
            PosNum = Text.PositionOf(Texte, "Numéro de facture"),
            NumFacture = if PosNum = -1 then null else
                Text.Middle(Texte, PosNum + Text.Length("Numéro de facture"), 30),
            NumNettoye = Text.Trim(Text.Select(NumFacture, {"0".."9", "-", "/"})),

            // B. Extraction de la Date d'émission
            PosDate = Text.PositionOf(Texte, "ve :,"),
            DateFacture = if PosDate = -1 then null else
                Text.Middle(Texte, PosDate + Text.Length("ve :,"), 10),
            DateNettoyee = Text.Trim(Text.Select(DateFacture, {"0".."9", "/"})),

            // C. Extraction du Montant à payer (Brut)
            PosMt = Text.PositionOf(Texte, "Montant à payer"),
            MontantBrut = if PosMt = -1 then null else
                Text.Middle(Texte, PosMt + Text.Length("montant brut"), 20),
            MtNettoye = Text.Trim(Text.Select(MontantBrut, {"0".."9", ",", "."})),

            // D. Extraction du Lieu de livraison
            PosLiv = Text.PositionOf(Texte, "Localité Adresse de livraison"),
            LieuLiv = if PosLiv = -1 then null else
                Text.Middle(Texte, PosLiv + Text.Length("Localité Adresse de livraison/réalisation de prestation :"), 40),
            // On récupère le premier mot qui suit)
            LieuNettoye = Text.Start(Text.Trim(LieuLiv), Text.PositionOf(Text.Trim(LieuLiv), " "))
        in
            [Num = NumNettoye, Date = DateNettoyee, Total = MtNettoye, Ville = LieuNettoye]
    )
in
    ExtractionDonnees
Le problème je pense est à l'étape 3 il n'extrait pas tout le document mais qu'une partie
Si quelqu'un pourrais regarder ou apporté sa propre solution ce serait cool
Je met en PJ un fichier PDF que j'ai anonymiser met touts les éléments se retrouve
Hello,
le souci c'est que ton PDF ne comporte pas vraiment des tables et que Power Query "galère" à récupérer les données . En python, il existe un module qui est capable d'aller récupérer des blocs de texte dans un PDF d'après ses coordonnées pages (ce qui semble possible avec ton document) , il s'agit de pymupdf. Avec le module pywin32 , on peut faire facilement un serveur com que l'on peut contacter en vba. Donc en résumé , il faut un python installé sur le poste (facilement installable avec microsoft store) et importer les modules pymupdf et pywin32. Pour enregistrer le serveur com il faut être administrateur. Alors si tu es en entreprise je doute que tu ais ces possibilités. En tout cas voilà ce que cela donne dans Excel pour ton fichier de test :
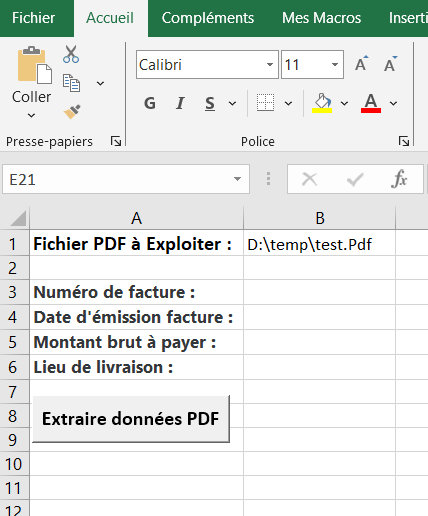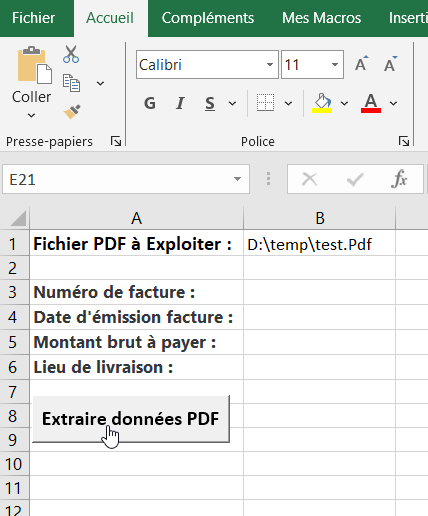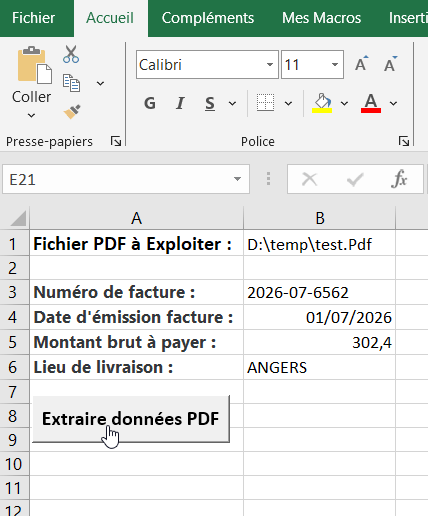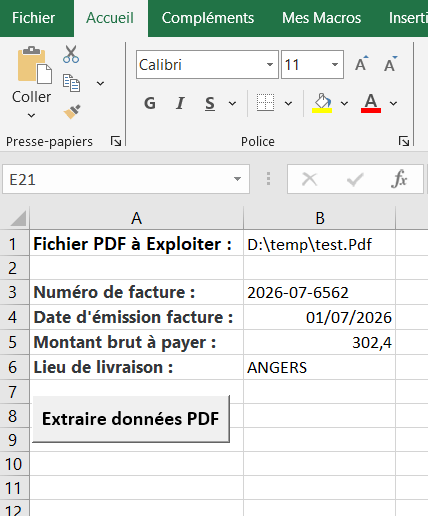
Comme on peut le constater c'est très rapide . Le code VBA :
Sub ExtrairePDF()
    Dim obj As Object
    Dim resultat As Variant
    Range("B3:B6").ClearContents
    Set obj = CreateObject("Python.ExtractPDF")
    resultat = obj.extractPDF(Range("B1").Text)
    Range("B3") = resultat(0)
    Range("B4") = CDate(resultat(1))
    Range("B5") = CDbl(resultat(2))
    Range("B6") = resultat(3)
End Sub
Le script python avec le serveur com et l'extraction PDF fait 135 lignes.
Ami calmant, J.P
Bonjour,
Merci c'est cool je vais regarder ce que je peux faire sinon je le ferais manuellement puis c'est tout 😊
Merci encore pour c'est explication
Cordialement,
Hello,
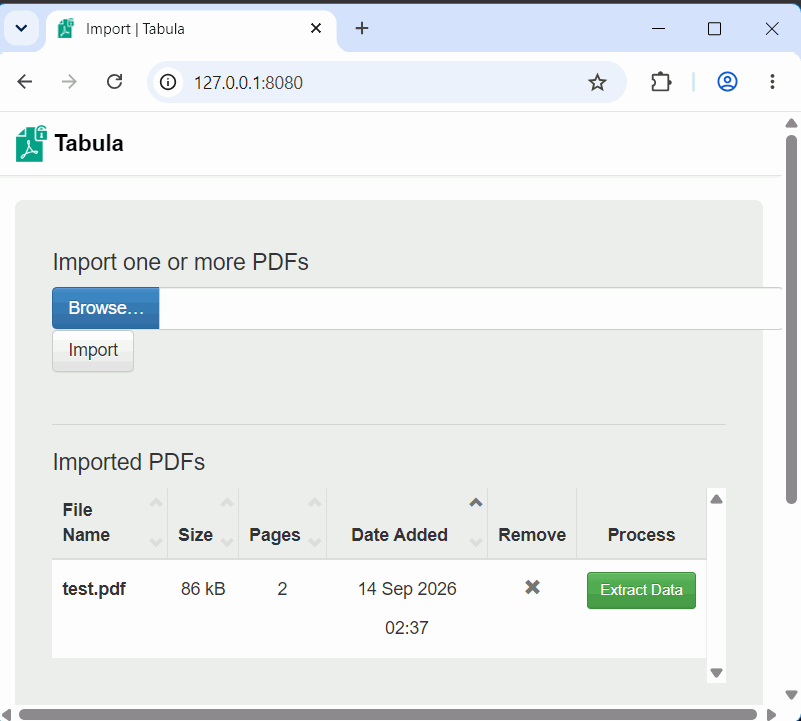
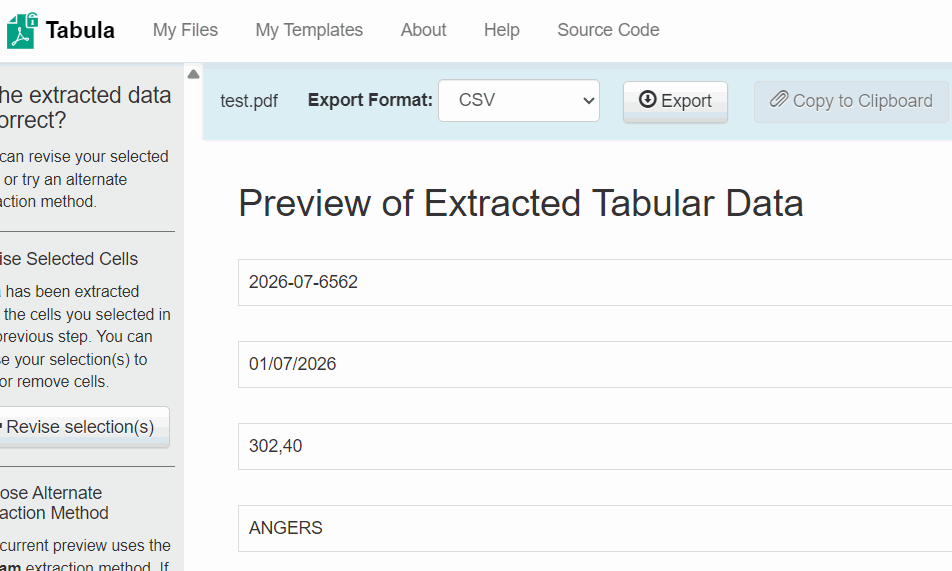
sinon il y a Tabula un logiciel gratuit (un peu usine à gaz en java mais simple d'emploi) qui tourne dans un navigateur, qui permet de définir des zones dans un modèle et d'extraire les données qui se trouvent dans ces zones. Exemple :
1 - On importe le PDF :
2 - Cliquer sur le bouton Extract Data
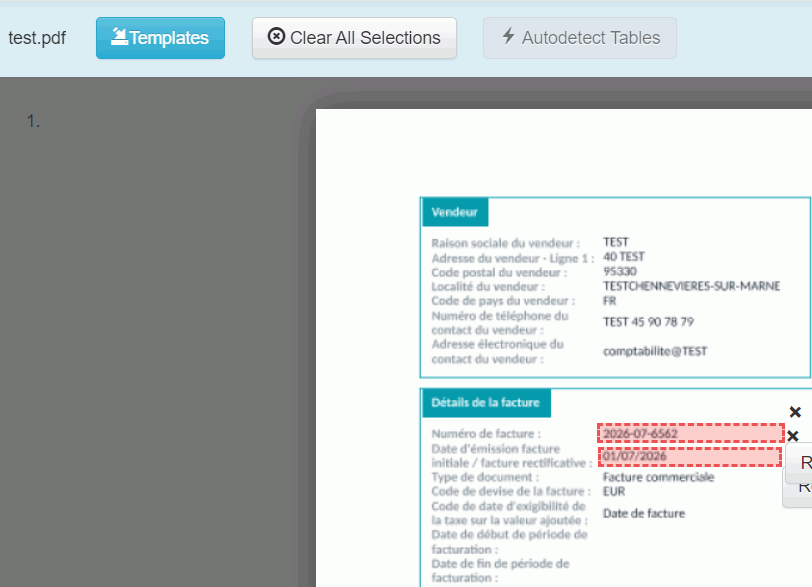
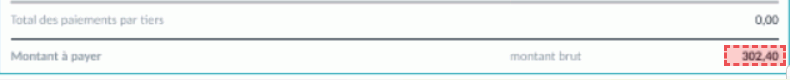
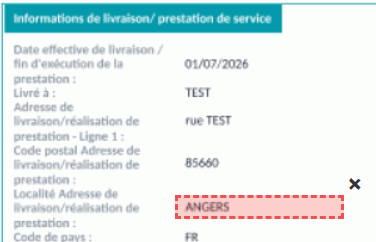
3 - On définit à la souris les zones pour l'extraction dans le modèle :
4 - On sauvegarde le modèle qu'on pourra utiliser dans d'autres PDFs (Templates/Save Selections as Template)
Et voilà ce que cela donne pour l'extraction :
Ami calmant, J.P
Finalement c'est faisable en Power Query avec expansion totale (pages et tables) et en se servant du numéro de ligne et de colonne pour cibler les données à extraire (en espérant que cela ne change pas suivant la facture ) :
let
    Source = Pdf.Tables(
        File.Contents(
            Excel.CurrentWorkbook(){[Name="Fichier"]}[Content][Column1]{0}
        )
    ),

    // Toutes les colonnes présentes dans toutes les pages
    Colonnes = List.Union(
        List.Transform(
            Source[Data],
            each Table.ColumnNames(_)
        )
    ),

    #"Data développé" = Table.ExpandTableColumn(
        Source,
        "Data",
        Colonnes,
        List.Transform(Colonnes, each "Data." & _)
    ),

    NumeroFacture = #"Data développé"{13}[Data.Column5],
    DateFacture = #"Data développé"{15}[Data.Column5],
    Montant = #"Data développé"{35}[Data.Column11],
    Ville = #"Data développé"{122}[Data.Column12],

    Resultat = #table(
        {"NumeroFacture", "Date", "Montant", "Ville"},
        {{
            NumeroFacture,
            DateFacture,
            Montant,
            Ville
        }}
    )

in
    Resultat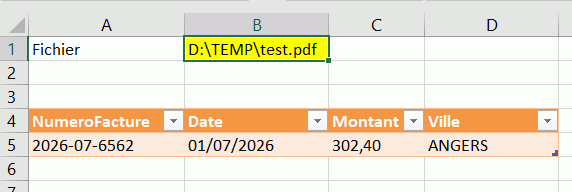
re,
vous avez tout les 2 la version 2016, mais à partir de 2019 (je pense), on a un outil (qui ne donne pas toujours une résultat satisfaisant) pour extraire un PDF et on peut utiliser VBA pour manipuler tout. Cela a l'air similaire à PQ
le résultat en PJ
.